
Hello, 各位 iT 邦幫忙 的粉絲們大家好~~~
這系列文源自這幾年在團隊裡導入 AI Coding 之後,一路踩雷、修正、再踩雷的真實過程。把這些收斂出來的方法整理成文,也許對正在煩惱同樣問題的你會有些幫助。
就當作是一份邊做邊記的工程筆記吧!
本篇是 當 AI 加入團隊:打造可審查、可驗證、會自我改善的 AI 開發工作流 系列文的 EP03。
有了骨架後,第一批真正搬進 skills/ 的內容,是既有的現場診斷經驗。例如「怎麼判斷某個裝置卡住了」、「日誌裡出現某個特徵字串代表什麼」——這類過去只活在資深工程師個人 SOP 裡的判斷。
這裡有個很重要的取捨:不是把所有歷史資料原封不動搬進來,而是挑出可重複的判斷與操作,改寫成 AI 能依條件載入的短文件。
一份 skill 大致長這樣:
# skill: remote-device-diagnosis

## Inputs
- 裝置連線資訊(主機、帳號、限制存取範圍)
- 懷疑的症狀描述

## Outputs
- 判斷結論(正常 / 疑似異常 / 需要進一步日誌)
- 建議的下一步

## Safety
- 唯讀操作優先;需要變更狀態的指令要先列出、再詢問是否執行
- 不得將裝置序號、帳密等敏感資訊寫回共用文件

## Validation
- 結論需附上實際下的指令與回傳內容,而不是「應該是這樣」
這個格式本身就在回答三件事:這個能力吃什麼、吐出什麼、以及它被允許做到什麼程度。有了這個格式,之後同事間互相 review 一份新技能時,也有共同的檢查點。
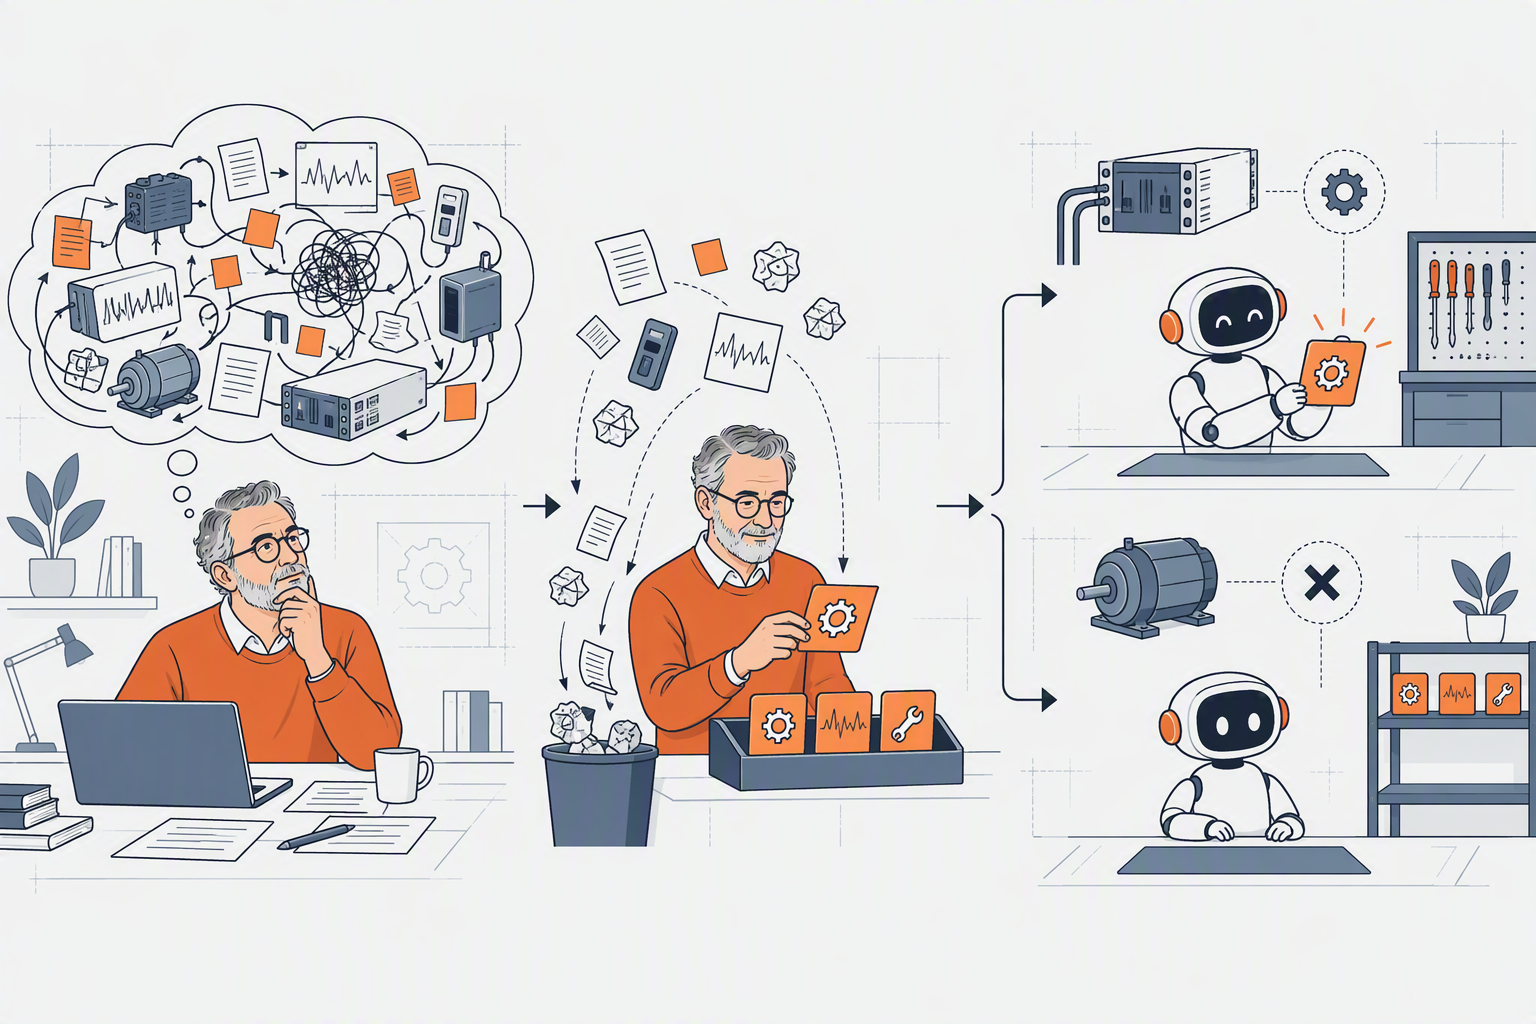
從這一步開始,AIOrchestrations 裡的內容不再只是「某人做過什麼」,而是逐步在回答「遇到什麼情況,該選哪個能力」。這個轉變看起來很小,但它是後面所有 router、manifest 設計的起點。
技能有了,那要怎麼把好幾個技能串成一條完整的工作流程呢?下一篇見。


 iThome鐵人賽
 看影片追技術